llma.cpp + QwenCoder Local
1
2
3
4
5
6
7
8
9
Système d'exploitation : EndeavourOS
Version de KDE Plasma : 6.8.0
Version de KDE Frameworks : 6.31.0
Version de Qt : 6.12.0
Version de noyau : 7.2.10-arch1-1 (64-bit)
Plate-forme graphique : Wayland
Processeurs : 4 × Intel® Core™ i5-7500 CPU @ 3.40GHz
Mémoire : 32 Gio de mémoire vive (31,2 Gio de RAM utilisable)
Processeur graphique : Mesa Intel® HD Graphics 630
Pour bash, JavaScript, Python et Markdown, ce sont des langages très bien couverts : inutile de viser un gros modèle dense. Ça confirme le choix MoE.
Configuration que je te conseille
- Chat / génération / refactoring : Qwen3-Coder 30B-A3B Instruct (Q4_K_M, ~18 Go). C’est le meilleur compromis qualité/vitesse sur ton CPU. Il gère bien les scripts bash, Python et JS, et il sait suivre un format Markdown précis.
- Option plus légère si tu trouves ça trop lent : Qwen2.5-Coder 7B Instruct (Q4_K_M, ~5 Go). Environ deux à trois fois plus rapide, un peu moins fiable sur les scripts bash complexes.
- Autocomplétion dans l’éditeur : Qwen2.5-Coder 1.5B base (le 7B base si tu acceptes la latence). Attention : avec seulement 4 cœurs, l’autocomplétion et le gros modèle de chat se disputent le CPU. Évite de les utiliser en même temps.
Jekyll / Chirpy : un point de vigilance
Le Liquid, les _config.yml, les front matters et la structure du thème Chirpy sont moins bien connus des petits modèles, qui peuvent inventer des options qui n’existent pas. Pour compenser :
- Colle dans le prompt le bout de
_config.ymlou le fichier de layout concerné. - Précise la version de Chirpy que tu utilises.
- Vérifie toujours avec
bundle exec jekyll build(oujekyll serve) plutôt que de te fier à la réponse.
Lancement (llama.cpp)
1
2
3
# Chat / agent (modèle principal)
llama-server -hf unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:Q4_K_M \
  -t 4 -c 16384 --jinja --port 8080
Ça expose une API compatible OpenAI sur http://127.0.0.1:8080/v1, utilisable depuis Continue.dev, Cline ou curl. Le nom exact du dépôt GGUF peut varier : vérifie-le sur Hugging Face avant de lancer. Sur EndeavourOS, llama.cpp s’installe via un paquet AUR ou en le compilant toi-même (conseillé pour exploiter AVX2).
Pour des scripts bash/Python rapides en terminal, tu peux aussi appeler le serveur directement avec curl ou un petit alias, sans passer par un éditeur. Dis-moi si tu veux que je t’écrive ce wrapper.
Voici une installation 100 % terminal pour EndeavourOS : llama.cpp compilé pour ton CPU, Qwen3-Coder téléchargé automatiquement, un serveur démarrable à la demande et des alias/fonctions pour l’utiliser en ligne de commande.
1. Installer llama.cpp (compilation locale)
❌ Ne pas compiler avec les bibliothèques partagées
1
2
3
4
5
6
sudo pacman -S --needed base-devel cmake git curl jq
git clone https://github.com/ggml-org/llama.cpp ~/src/llama.cpp
cd ~/src/llama.cpp
cmake -B build -DGGML_NATIVE=ON -DLLAMA_CURL=ON
cmake --build build --config Release -j4
cmake --install build --prefix ~/.local
Vérifie que ~/.local/bin est dans ton PATH, puis teste :
1
llama-server --version
✅ Compilation en mode statique
Il faut effacer les llma de ~/.local/bin/ de la compilation précédente avant compilation en mode statique ?Non, ce n’est pas obligatoire : cmake --install écrase les binaires existants. Mais pour éviter les restes (anciennes bibliothèques .so dans ~/.local/lib, headers, etc.), le plus propre est de désinstaller l’ancienne version avant de supprimer le dossier build, grâce à la liste de fichiers que cmake a gardée :
1
2
3
cd ~/src/llama.cpp
xargs rm -v < build/install_manifest.txt     # supprime uniquement ce que cmake avait installé
rm -rf build
Ensuite, recompile en statique :
1
2
3
4
5
cd ~/src/llama.cpp
cmake -B build -DGGML_NATIVE=ON -DLLAMA_CURL=ON -DBUILD_SHARED_LIBS=OFF
cmake --build build --config Release -j4
cmake --install build --prefix ~/.local
llama-server --version
version: 0.7.0-dev (build 11756, commit d80619397)
built with GNU 16.2.1 for Linux x86_64
L’avantage de passer par install_manifest.txt est que tu ne risques pas d’effacer d’autres fichiers de ~/.local/bin avec un rm llama* trop large. Si le fichier n’existe pas (build déjà supprimé), un simple rm ~/.local/bin/llama-* suffit, puis rm -f ~/.local/lib/libllama* ~/.local/lib/libggml* ~/.local/lib/libmtmd*.
2. Télécharger et tester le modèle
Avec -hf, llama.cpp télécharge le GGUF au premier lancement (cache dans ~/.cache/llama.cpp) :
1
llama-cli -hf unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:Q4_K_M -t 4 -c 16384
A la fin du téléchargement
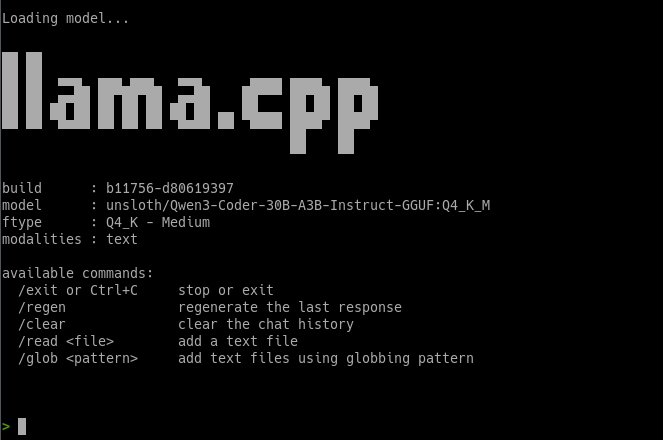 Saisir
Ctrl+C
Le nom exact du dépôt peut changer : si l’erreur indique qu’il est introuvable, cherche-le sur Hugging Face. Compte ~18 Go de téléchargement, puis un chargement de quelques dizaines de secondes à chaque lancement.
On peut lancer la commande
llama-cli -hf unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:Q4_K_M -t 4 -c 16384de n'importe quel dossier ?
Oui, depuis n’importe quel dossier. Deux choses l’expliquent :
- Le binaire est trouvé via le
PATH: tonwhich llama-servera déjà montré que~/.local/biny est, doncllama-cli(installé au même endroit) l’est aussi. - Le modèle est téléchargé une seule fois dans le cache global (
~/.cache/llama.cpp, ou$LLAMA_CACHEs’il est défini), pas dans le dossier courant. Les lancements suivants le réutilisent sans retélécharger.
Le dossier courant n’a donc pas d’importance pour le chargement du modèle. Il compte seulement si tu passes des chemins relatifs, par exemple -f prompt.txt pour lire un prompt depuis un fichier.
3. Serveur en arrière-plan (service utilisateur, démarrage manuel)
Charger 18 Go à chaque question serait pénible : on garde donc le modèle chargé dans un serveur que tu démarres quand tu en as besoin.
1
2
3
4
5
6
7
8
9
10
mkdir -p ~/.config/systemd/user
cat > ~/.config/systemd/user/llama-server.service <<'EOF'
[Unit]
Description=llama.cpp server (Qwen3-Coder)

[Service]
ExecStart=%h/.local/bin/llama-server -hf unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:Q4_K_M -t 4 -c 16384 --jinja --host 127.0.0.1 --port 8080
Restart=on-failure
EOF
systemctl --user daemon-reload
Je ne l’active volontairement pas au démarrage : il occupe ~20 Go de RAM tant qu’il tourne.
4. Alias et fonction (~/.bashrc)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# llama-server
alias iaon='systemctl --user start llama-server'
alias iaoff='systemctl --user stop llama-server'
alias iachat='llama-cli -hf unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:Q4_K_M -t 4 -c 16384'

# Question en une ligne, avec entrée par pipe optionnelle, réponse en streaming
ia() {
  local prompt="$*" input=""
  [ ! -t 0 ] && input=$(cat)
  jq -n --arg p "$prompt" --arg i "$input" '{
      stream: true,
      messages: [
        {role: "system", content: "Réponds en français, de façon concise."},
        {role: "user", content: ($p + (if $i != "" then "\n\n" + $i else "" end))}
      ]}' \
  | curl -sN http://127.0.0.1:8080/v1/chat/completions \
      -H 'Content-Type: application/json' -d @- \
  | sed -u 's/^data: //' \
  | grep --line-buffered -v -e '^\[DONE\]' -e '^$' \
  | jq --unbuffered -rj '.choices[0].delta.content // empty'
  echo
}
Recharger
1
source ~/.bashrc
5. Utilisation
1
2
3
4
5
6
iaon                                   # démarre le serveur (attendre le chargement)
ia "Comment lister les fichiers de plus de 100 Mo en bash ?"
cat script.sh | ia "Explique et corrige ce script"
git diff | ia "Rédige un message de commit"
cat _posts/mon-article.md | ia "Relis ce post Chirpy, vérifie le front matter"
iaoff                                  # libère la RAM
iachat lance à la place une conversation interactive directement dans le terminal, sans serveur (le modèle est chargé à chaque lancement).
Pour suivre le chargement du serveur : journalctl --user -u llama-server -f.
Au passage, avec ton CPU, attends-toi à un démarrage de réponse un peu lent si tu envoies un gros fichier en entrée : c’est la lecture du prompt qui coûte, pas la génération.
j'ai du mal à comprendre la nuance iachat avec le fait de démarrer le serveur ..?Ce sont deux façons différentes d’utiliser le même modèle.
La commande charge le modèle en RAM, ouvre une conversation interactive dans ton terminal, et quand tu quittes (Ctrl+C), le modèle est déchargé. C’est simple : une commande, une session. Mais chaque lancement recharge ~18 Go, ce qui prend du temps.
iaon démarre llama-server en arrière-plan : le modèle se charge une seule fois et reste en RAM jusqu’à iaoff. Tu envoies ensuite des questions quand tu veux avec ia "...", sans rechargement. Le gros avantage : tu peux envoyer des fichiers ou des sorties de commandes par pipe, ce qui n’est pas pratique avec une session interactive :
1
2
git diff | ia "Rédige un message de commit"
cat script.sh | ia "Corrige ce script"
En résumé
iachat |
iaon + ia |
|
|---|---|---|
| Usage | Discussion interactive | Questions rapides, pipes, scripts |
| Chargement du modèle | À chaque lancement | Une fois, puis il reste en RAM |
| Mémoire pendant l’inactivité | Libérée dès que tu quittes | ~20 Go occupés jusqu’à iaoff |
| Historique de conversation | Oui, dans la session | Non : chaque ia est indépendant |
Conseil : pour discuter longuement, iachat ; pour des questions ponctuelles ou pour traiter des fichiers, démarre le serveur avec iaon. Les deux n’ont pas besoin d’être utilisés ensemble : ne lance pas les deux en même temps, car chacun charge le modèle (~18 Go) et tu saturerais tes 32 Go.